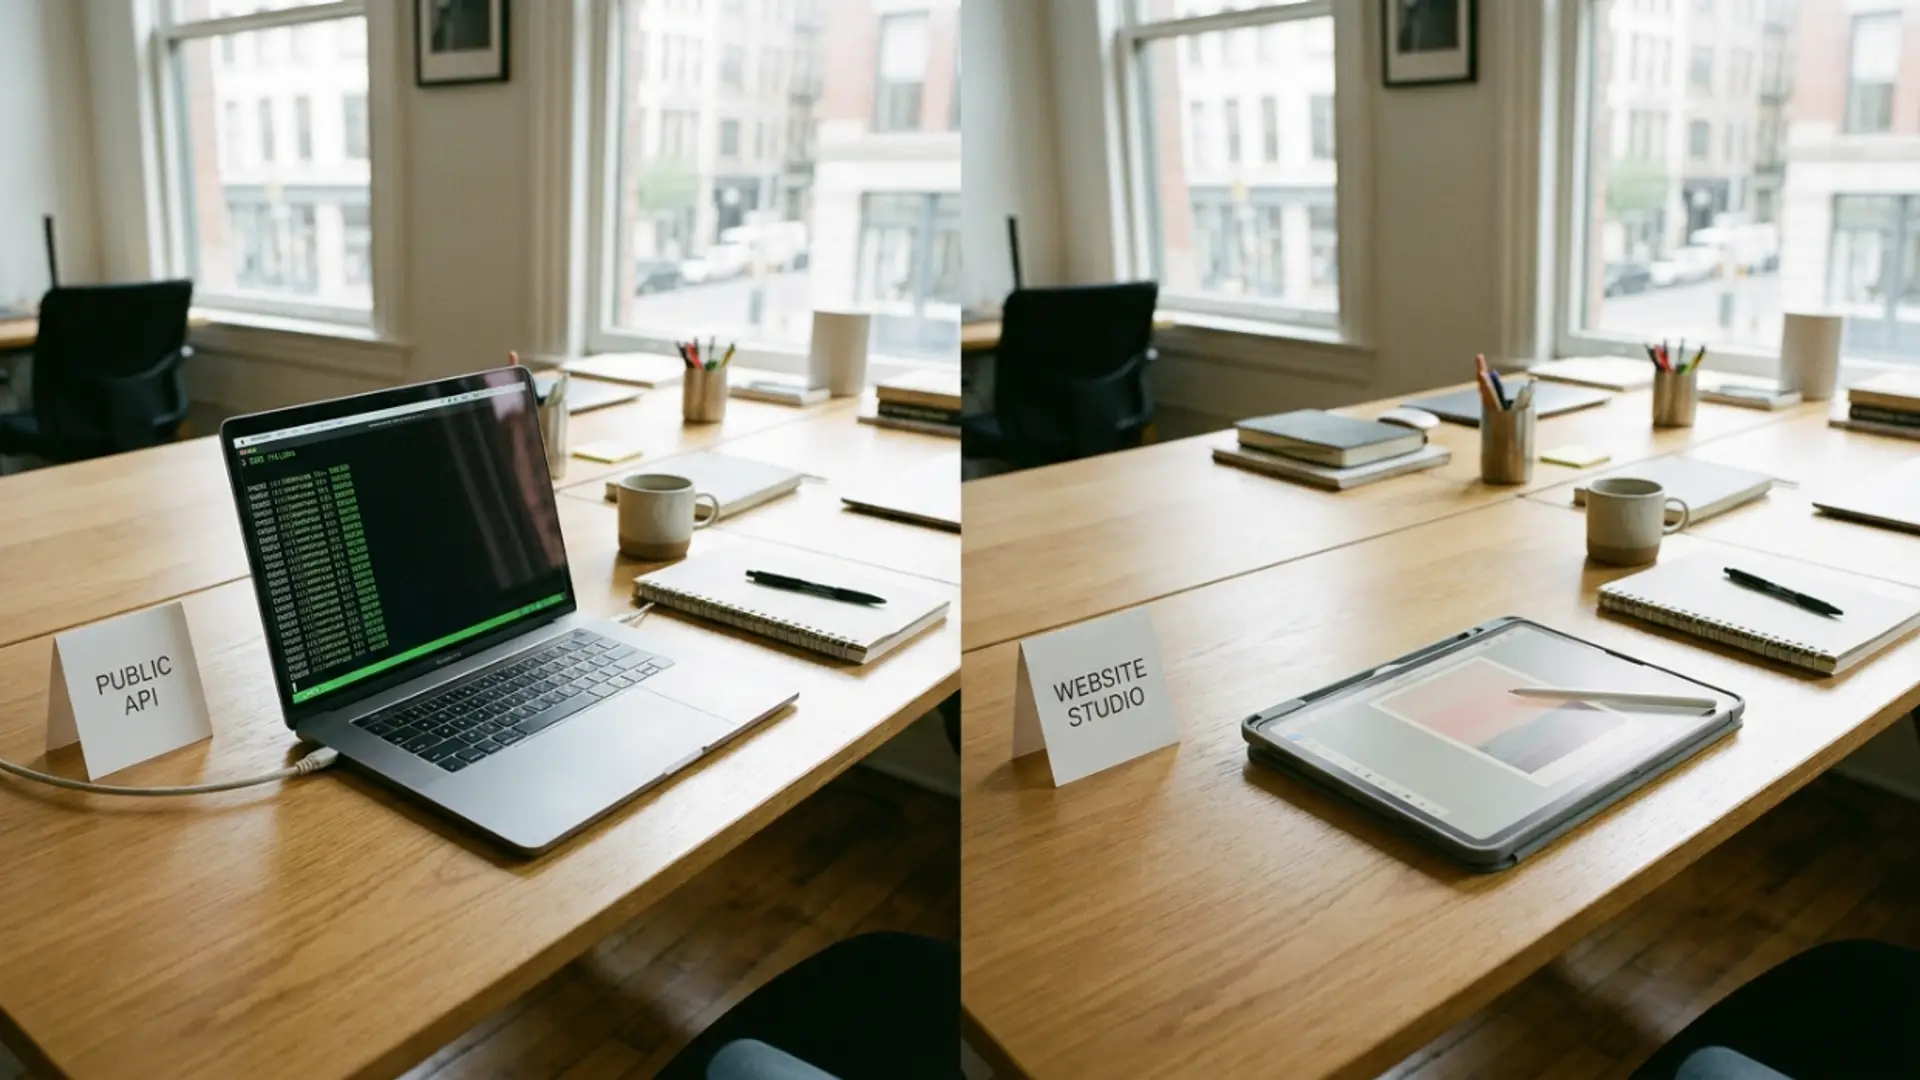
API pública frente al estudio de la web
Mismo proceso, mismos créditos y dos formas muy distintas de trabajar. Cuándo compensa montar la API de Picverce AI y cuándo el estudio es más rápido.
RecomendacionesLa API no es una versión mejor de la web. Es el mismo proceso con la interfaz quitada, y esa ausencia es a la vez la gracia y el coste.
Lo que es realmente idéntico
Más de lo que la gente espera, y por eso la elección va de flujo de trabajo y no de capacidad.
- Los mismos modelos corren detrás de ambas. Un trabajo por cualquier vía hace lo mismo con tu archivo.
- Los créditos salen de un saldo compartido y cuestan lo mismo por trabajo.
- Se aplican los mismos límites de archivo.
- Los resultados caen en el mismo historial en los dos casos.
Puedes comprobarlo en un minuto. Pasa un archivo por el directorio de herramientas a mano, luego el mismo archivo por la API, y compara los dos resultados.
Lo que cambia es todo lo que rodea al trabajo, no el trabajo en sí.
Ese es el marco útil de toda la comparación. No eliges entre dos productos, eliges si aprieta el botón una persona o un script.
Lo que te da el estudio y la API no
Ver el resultado al momento es lo grande, y pesa más de lo que suena.
Elegir un estilo es una decisión visual. Nadie elige entre dieciocho tarjetas de boceto leyendo sus nombres en una respuesta de catálogo.
El estudio también deja cambiar de opinión barato. Pruebas una tarjeta, no te convence, pruebas otra, sin escribir nada.
Y no hay montaje ninguno. Ni clave, ni requisito de plan, ni bucle de consulta, ni gestión de errores.
Para menos de unos veinte archivos yo sigo abriendo la web. Montar la API cuesta más tiempo del que ahorra a ese volumen.
El estudio se encarga además de las partes incómodas del archivo. La conversión de formato y los límites de subida se resuelven antes de que los notes.
Lo que te da la API y el estudio no puede
Repetición sin una persona, básicamente. Esa es toda la categoría.
Todo lo que puede ejecutar está listado en la documentación de la API pública, y los puntos finales de catálogo devuelven la misma lista en tiempo de ejecución para que nunca la fijes en el código.
Cuatrocientos trabajos idénticos no es algo que nadie deba clicar, y ahí el montaje se paga varias veces.
También mete el trabajo dentro de otra cosa. Un trabajo que se lanza cuando añades un producto a tu propio sistema no es algo que una página de estudio pueda hacer.
Consigues además gestión de errores de verdad. Un trabajo fallido devuelve un motivo y un reembolso, y tu código decide si reintenta o lo salta.
Y pueden avisarte cuando el trabajo termina en lugar de vigilarlo, registrando una dirección en tu cuenta.
Los reintentos también son más seguros. Un valor de idempotencia en la creación permite repetir una llamada caída a medias sin pagar dos veces, y eso no tiene equivalente en una pestaña de navegador.
A cuál recurrir
La pregunta del volumen lo resuelve casi siempre.
Por debajo de veinte archivos, o en cualquier encargo donde tengas que mirar cada resultado, usa el estudio. Es más rápido en tiempo real aunque parezca menos sofisticado.
Por encima de cien archivos idénticos, usa la API. Por debajo de eso la respuesta depende de si va a repetirse.
Un lote único de cincuenta es una tarde de estudio. Un lote de cincuenta que llega cada semana es un script que escribes una vez.
La segunda pregunta es si el trabajo tiene que arrancar solo. Cualquier cosa disparada por tu propio sistema y no por una persona es trabajo de API, sea cual sea el volumen.
Un lote semanal que alguien se acuerda de lanzar sigue siendo trabajo de estudio. Un lote que debe correr se acuerde alguien o no, no lo es.
Si una persona tiene que juzgar cada archivo, la API es la herramienta equivocada sea cual sea el volumen. La automatización es para decisiones ya tomadas.
Los costes que la gente olvida
El acceso no es gratis con una cuenta gratuita. Necesitas un plan Basic, Standard o Premium activo, o un paquete de créditos.
Cada trabajo es asíncrono, así que estás escribiendo un bucle de consulta o una dirección que reciba avisos. Eso es trabajo real que el estudio te hace.
Los límites de uso son reales y tu primer script los va a tocar. Leer las cabeceras de límite en lugar de adivinar esperas es la solución.
Y una clave es un secreto. Poner una en código de navegador entrega tus créditos a quien abra las herramientas de desarrollo.
Ninguna de las dos vías cambia qué herramienta conviene para una foto. Esa decisión es la misma en ambas, y la lógica de orden está en mejorador o ampliador cuál conviene lanzar primero.
Elige por cuántas veces se repite el trabajo y por si una persona tiene que mirar. Todo lo demás es igual por debajo.